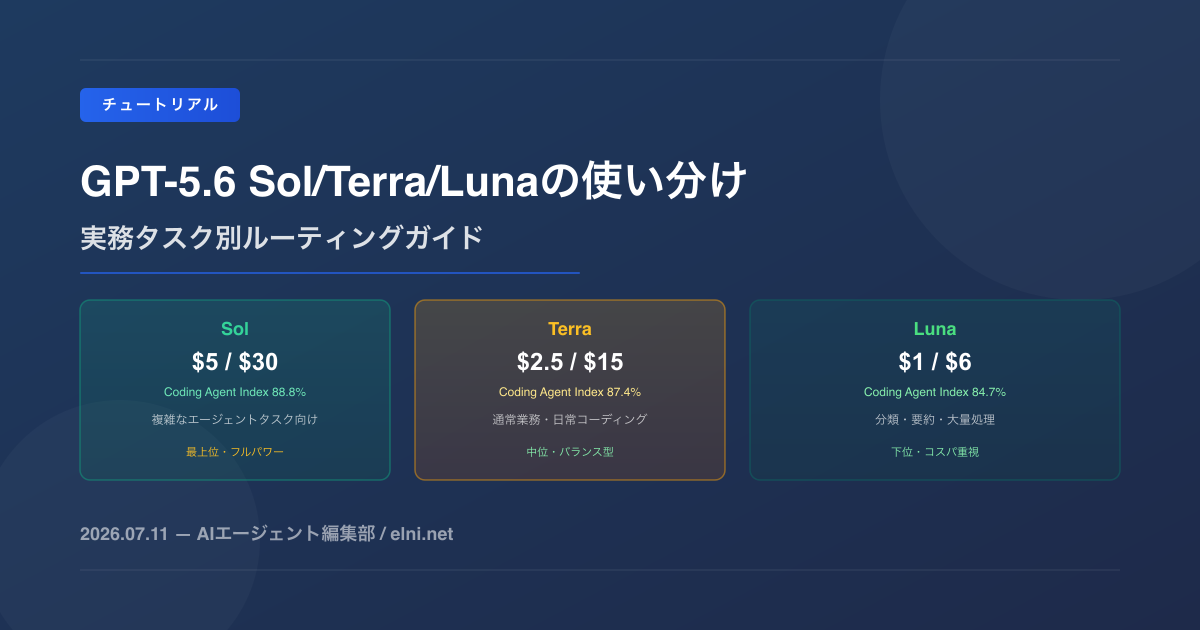
はじめに——GPT-5.6は「1モデル」ではなく「3段階のTier」
「GPT-5.6を使う」と一言で言っても、実はそこには3つの選択肢が隠れています。上から順にSol・Terra・Lunaという3つのTierで、それぞれ価格も得意なタスクも違う。要するに、GPT-5.6は1つの製品というより「3種類の道具箱」だと考えたほうがしっくりきます。この記事では、どのタスクにどのTierを割り当てるべきかを、価格・ベンチマーク・実務比較の3方向から整理していきます。
比較の物差しとしてClaude Opus 4.8(現行の既定モデル)とGrok 4.5の実務ベンチも交えます。「結局どれが一番強いか」ではなく、「今日のこのタスクに、どのTierを割り当てるか」という実務判断のためのガイドです。
価格とベンチマークで見る3Tierの実力
Sol/Terra/Lunaの価格表
| Tier | 入力($/Mtok) | 出力($/Mtok) | 位置づけ |
|---|---|---|---|
| Sol | $5 | $30 | 最上位・フルパワー |
| Terra | $2.5 | $15 | 中位・バランス型 |
| Luna | $1 | $6 | 下位・コスパ重視 |
出典: OpenAI公式発表(2026年7月)。価格は100万トークンあたり。
ここで迷いやすいのが、「一番高いSolが一番賢い」という単純な図式で考えてしまうこと。実はTerraやLunaも決して見劣りしない実力を持っています。次のベンチマークを見ると、その理由がわかります。
Terminal-Bench・Artificial Analysis Coding Agent Indexの結果
| モデル | Artificial Analysis Coding Agent Index | Terminal-Bench |
|---|---|---|
| GPT-5.6 Sol | 88.8% | 80点 |
| GPT-5.6 Terra | 87.4% | — |
| GPT-5.6 Luna | 84.7% | — |
| Claude Opus 4.8 | 78.9% | — |
出典: Artificial Analysis / Terminal-Bench各公開値(2026年7月時点)。指標間は評価条件が異なるため単純な横並び比較はできない点に注意。
ここで迷いやすいポイント
最下位のLunaでさえ84.7%と、Claude Opus 4.8の78.9%を上回っています。つまり「Lunaは安かろう悪かろう」ではなく、コーディングエージェント用途では下位Tierでも十分戦力になるということ。価格差(SolはLunaの5倍)ほどには性能差が開いていない点が、このTier構成の面白いところです。
Claude・Geminiとの実務比較軸
Claude Opus 4.8との価格・コーディングコスト比較
Claude Code内での実測ベースで見ると、Solのコストは(Fable 5のmax構成比で)約40%安く、Opus 4.8のmax構成比でも約10%安いという結果が報告されています。要するに、最上位Tier同士を比べても、GPT-5.6 Solのほうがやや財布に優しいという位置関係です。ただし、Claude Opus 4.8は2026年7月時点でClaude Code/API既定モデルに昇格したばかりで、highエフォート既定・xhighエフォート(最難関タスク向け)という運用面の柔軟性も持っています。単純な価格比較だけでなく、エフォート設定込みで自分のワークロードに当てはめて考えたいところです。
Grok4.5のGDPval+実務ベンチ
もうひとつ見逃せないのが、Snorkel AIの実務タスク評価「GDPval+」の結果です。Grok 4.5が平均合格率29%でトップ、GPT-5.5が22%、Claude Opus 4.8が21%と続きます。実は、この数字だけを見るとGrok 4.5が実務では最強に見えますが、Grok 4.5は幻覚率がGrok 4.3の25%から54%へ倍増しているという副作用も抱えています。つまり「正解率は高いが、外すときは大きく外す」という荒削りな強さ。裏取りが不要な低リスクタスクでは魅力的でも、ミスが致命傷になる業務ではまだ慎重に使うべき段階だと言えるでしょう。
実務タスク別ルーティング表(推奨)
| タスクの性質 | 推奨Tier |
|---|---|
| 複雑なエージェントタスク・専門調査・高難度な問題解決 | Sol |
| 通常業務・日常的なコーディング | Terra |
| 分類・要約・抽出といった大量処理タスク | Luna |
この表のポイントは、「難しいタスクほど上位Tierへ」という単純な一直線の発想ではなく、タスクの性質で振り分けるという点です。複雑なエージェントタスクや専門調査はSolに任せ、日々のコーディングのようなボリュームゾーンはTerraで回し、分類・要約・抽出のような定型的な大量処理はLunaに流す。ここで迷いやすいのが「念のため全部Solでやればいいのでは」という発想ですが、それでは価格差5倍のコストを常に払い続けることになります。タスクの難易度と発生頻度を見極めて、Tierごとにルーティングを設計するのが実務的です。
まとめ——「最強」より「今日の自分に合うTier」
GPT-5.6を評価するときに「Solが一番強いから常にSolを使えばいい」と考えるのは早計です。Terraは価格の半額以下でSolに肉薄する性能を出しますし、Lunaでさえ既定モデルのClaude Opus 4.8を上回るコーディング性能を見せています。つまり、GPT-5.6を使いこなす鍵は「最強のモデルを選ぶこと」ではなく「タスクごとに適切なTierへルーティングすること」にあります。Claude Opus 4.8やGrok 4.5といった他社の実務ベンチも併せて眺めながら、自分の業務にとっての「今日ちょうどいいTier」を見つけていきましょう。
本記事は7月5日公開の3社比較記事とは異なる切り口です。あちらはGPT-5.6・Claude Sonnet 5・Gemini 3.1 Proの「単一モデル対決」でしたが、本記事はGPT-5.6内部の3Tier使い分けに焦点を当て、Claude側の比較対象も現行既定モデルのOpus 4.8に更新、Grok 4.5の最新実務ベンチも反映しています。あわせて本日のAI最新情報まとめもご覧ください。