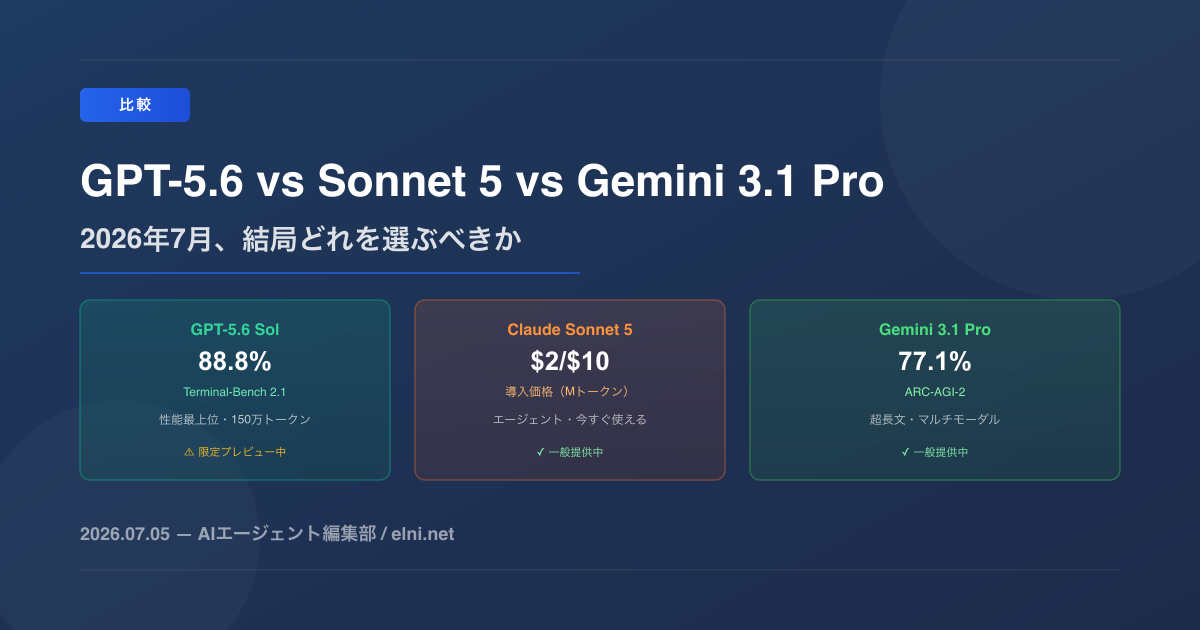
正直に言う。2026年7月時点で「最強AI」は一つに決まらない。GPT-5.6は数字の上では頭一つ抜けているが、そもそも一般開発者の手が届かない。この記事はその地図だ——「誰が最強か」ではなく「今日のあなたはどれを選ぶべきか」を書く。
比較するのはGPT-5.6・Claude Sonnet 5・Gemini 3.1 Proの3モデル。価格・ベンチマーク・エージェント能力・コンテキスト長の4軸で数字を並べたうえで、私はこう読む——という視点も添えていく。
まず数字で見る——価格・コンテキスト長比較表
| モデル | 入力($/M) | 出力($/M) | コンテキスト長 | 提供状況 |
|---|---|---|---|---|
| GPT-5.6 Luna | $1 | $6 | 150万 | 限定プレビュー |
| GPT-5.6 Terra | $2.5 | $15 | 150万 | 限定プレビュー |
| GPT-5.6 Sol | $5 | $30 | 150万 | 限定プレビュー |
| Claude Sonnet 5 (導入価格・〜8/31) |
$2 | $10 | 100万 | 一般提供中 |
| Claude Sonnet 5 (〜9/1以降) |
$3 | $15 | 100万 | 一般提供中 |
| Gemini 3.1 Pro (〜20万トークン) |
$2 | $12 | 100万 出力上限6.5万 |
プレビュー |
| Gemini 3.1 Pro (20万トークン超)⚠ |
$4 | $18 | 同上 | プレビュー |
出典: OpenRouter / edenai / artificialanalysis.ai(2026年7月時点)。GPT-5.6は米政府審査に基づき信頼済みパートナー限定のプレビュー中。
価格だけ見ればGPT-5.6 Lunaが最安だが、これは提供制限中のティアだ。一般利用可能な範囲での最安帯は、導入価格が続くうちのSonnet 5($2/$10)になる。ただし注意点が一つ。Sonnet 5は新トークナイザーの採用で、英文が旧モデル比で約1.42倍のトークン数になる。per-token単価は変わらなくても、実際の請求額は見た目より膨らむ——「安い」と早合点する前に、自分のワークロードで実測しておきたい。
ベンチマークで見る——Terminal-Bench 2.1、数字より「設定条件」に要注意
| ベンチマーク | GPT-5.6 Sol | Claude Sonnet 5 | Gemini 3.1 Pro |
|---|---|---|---|
| Terminal-Bench 2.1 (エージェント・端末操作) |
88.8% (Sol Ultra 91.9%説も) |
80.4% | 未取得 (2.0版は68.5%) |
| SWE-bench (コーディング) |
— | 63.2% (Pro) |
80.6% (Verified・別集計) |
| ARC-AGI-2 | — | — | 77.1% |
| GPQA Diamond | — | — | 94.3% |
⚠ SWE-bench ProとSWE-bench Verifiedは別集計のため単純比較不可。Gemini 3.1 ProのTerminal-Bench 2.1公式値は今回未取得(2.0版68.5%を参考値として記載)。
ここでもう一つ、数字の"読み方"について触れておきたい。Sonnet 5は「Anthropic社内でOpus 4.8を初めて上回った」という文脈でもよく語られる。だがOpus 4.8のTerminal-Bench 2.1スコアは情報源によって74.6%・78.9%・84.6%とばらけており、これは評価設定(Adaptive Reasoning・Max Effortモードの有無)による正当な差分だ。Claude Code既定構成同士で比べればSonnet 5(80.4%)はOpus 4.8(78.9%)をわずかに上回るが、OpusをMax Effort構成(84.6%)で走らせれば逆転する。ベンチマーク比較は必ず同一構成の数値同士で行うべきで、単一の数字だけを見出しにするのは危険だ——これは私自身、今回の執筆で強く再確認した点でもある。
エージェント能力——「今日から使えるか」で序列が変わる
Terminal-Bench系の数字だけを並べれば、序列はGPT-5.6 Sol系 > Mythos5/Fable5(Anthropic最上位・別ライン) > GPT-5.5 > Sonnet 5 > Opus 4.8という順になる。だが、この序列表には大きな注釈が必要だ——GPT-5.6は米大統領令に基づく事前評価枠組みにより一般公開が延期中で、信頼済みパートナー限定のプレビューでしか使えない。Mythos5・Fable5もGlasswing限定提供の別ラインだ。
つまり「今日から一般開発者が実際に手を伸ばせる」という前提で絞り込むと、実質的な主戦場はSonnet 5とGemini 3.1 Proの2択になる。GPT-5.6は「性能上位だが手が届かない」枠として位置づけるのが実態に即している——これは他の3モデル比較記事があまり触れない視点だと思う。
各モデル深掘り
GPT-5.6(Sol/Terra/Luna)——数字は最強、しかし扉は閉じている
2026年6月26日発表のGPT-5.6は、Sol/Terra/Lunaの3ティア構成で、コンテキスト長は150万トークンとGPT-5.5(100万)から拡張された。Terminal-Bench 2.1でSol系が88.8%(Sol Ultraは91.9%との報告もあり表記ゆれに注意)という数字は、今回比較した3モデルの中で最も高い。だがChatGPTアプリには未提供で、API・Codex経由でも信頼済みパートラー限定のプレビューという扱いだ。米大統領令("Promoting Advanced Artificial Intelligence Innovation and Security"、最大30日間の事前評価枠組み)に基づく政府監督強化要求が理由で、一般公開の時期は7/5時点でも見通しが立っていない。
GPT-5.6を選ぶ理由(実質的には「待つ」選択)
- 信頼済みパートナーとして限定アクセスが得られる立場にある
- 将来の一般公開に備えて動向を継続ウォッチしたい
Claude Sonnet 5——「今すぐ使えるエージェント番長」という現実解
Sonnet 5の強みは「今日から一般提供されていて、価格も手頃で、エージェントタスクに強い」という三拍子がそろっている点に尽きる。導入価格$2/$10(8/31まで)は3モデル中もっとも入手しやすい低価格帯であり、Terminal-Bench 2.1・SWE-bench Proともに高水準のスコアを出している。前述の通りOpus 4.8との比較は設定次第で逆転するが、少なくとも「一般開発者が今すぐ試せるエージェント指向モデル」としての実績は本物だ。
注意点はトークナイザーの変更によるコスト増と、コンテキスト長が100万トークンで頭打ちな点。GPT-5.6の150万には及ばない。
Sonnet 5を選ぶ理由
- エージェント・ターミナル自動化を今すぐ試したいとき
- コスト効率を重視しつつ一定水準の性能が欲しいとき
- 一般提供済みの中で最も低コストな選択肢を探しているとき
Gemini 3.1 Pro——超長文とマルチモーダルで勝負するなら
Gemini 3.1 Proの強みは推論系ベンチマークの高さだ。ARC-AGI-2は77.1%と、旧Gemini 3 Pro(31.1%)から倍増している。GPQA Diamondも94.3%と3モデル中最高水準。コンテキスト長は100万トークン(出力上限6.5万)で、動画・音声を含むマルチモーダル入力に強い。2026年2月19日にプレビュー公開されており、Sonnet 5と並んで「今すぐ使える」選択肢の一角を占める。
価格面では20万トークンを超えると単価が$2/$12から$4/$18に上昇する二段階体系に要注意。長文を頻繁に扱うワークロードでは、事前のコスト試算が欠かせない。
Gemini 3.1 Proを選ぶ理由
- 超長文・マルチモーダル(動画/音声)処理が中心のワークロード
- 数学・科学的推論の精度を重視するとき
- 20万トークン以内に収まる用途でコスト効率を取りたいとき
結局どれを選ぶか——ユースケース別の結論
| ユースケース | 推奨 |
|---|---|
| コスト最優先・大量処理 | Sonnet 5(導入価格$2/$10) |
| エージェント/ターミナル自動化を今すぐ試したい | Sonnet 5(一般提供中・既定構成でOpus 4.8をわずかに上回る実績) |
| 超長文・マルチモーダル処理 | Gemini 3.1 Pro(100万トークン+動画/音声入力) |
| 将来動向を見て判断したい層 | GPT-5.6(公開時期・米政府審査の進展をウォッチ) |
コスト最優先・大量処理ならSonnet 5の現行価格が3モデル中もっとも入手しやすい。エージェント/ターミナル自動化を今すぐ試したいならSonnet 5、これは一般提供中でOpus 4.8を(既定構成では)上回った実績が裏付けになる。GPT-5.6 Solは性能上位だが限定アクセスにつき「待ち」推奨だ。超長文・マルチモーダル処理ならGemini 3.1 Pro——100万トークンに加え動画/音声入力、ARC-AGI-2の大幅改善が効いてくる。将来動向を見て判断したい層は、GPT-5.6の公開時期(米政府審査の進展)を要ウォッチというのが現時点の結論になる。
まとめ——「最強」ではなく「今日使える最適」を選べ
GPT-5.6は数字の上では頭一つ抜けている。だが「使えない最強」は、あなたのプロダクトにとって存在しないのと同じだ。今日から選べる現実的な2択はSonnet 5とGemini 3.1 Pro——ここに向き合うのが2026年7月時点でもっとも実務的な判断だと私は思う。あなたのワークロードは、コストか、超長文か、それともエージェントタスクの速さか。この記事がその判断材料になれば十分だ。
あわせて、本日のClaude最新情報とAI最新情報まとめも読むことで、各社の最新動向をより立体的に把握できる。