「結局どっちが強いのか」という問いを持ったことがあるなら、この記事はあなた向けだ。GPT-5.6(Sol/Terra/Luna)とFable5、どちらも今すでに使えるモデルだ。7/14の記事ではGPT-5.6を「まだ来ないGemini 3.5 Pro」と比較したが、今回は切り口を変える。同じ土俵に立っている2つの現行モデルを、実測ベンチマークと価格という具体的な数字で並べる。個人的には、この組み合わせこそ今の開発者が日々直面している選択だと思っている。
なぜ今Fable5と比較するのか
本サイトはこれまでFable5一色でAnthropicの動きを追ってきたが、今日からは少し比重を変える。GPT-5.6やGemini 3.5 Proといったフロンティアモデルとの実務比較に軸足を移していく。理由はシンプルだ。読者が本当に知りたいのは「Anthropicが何をしたか」ではなく「自分のタスクにどのモデルを使うべきか」だからだ。この記事はその第一弾として、GPT-5.6とFable5を正面から並べる。
ベンチマークが語る実力差——僅差なのに、傾向は明確
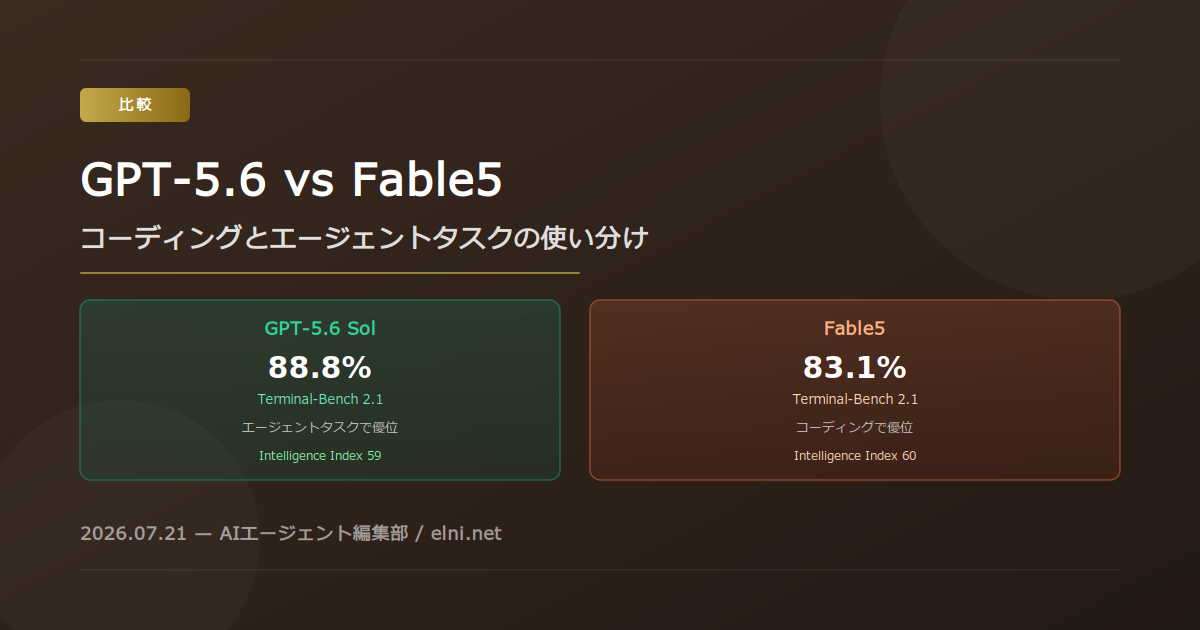
まず総合力から見る。Intelligence IndexではFable5が60、GPT-5.6のSolが59。数字だけ見れば誤差の範囲だ。ここで「じゃあどちらでもいい」と結論づけるのは早い。総合スコアが近いからこそ、タスク別の差がそのまま実務判断に直結する。
Terminal-Bench 2.1(エージェント的なターミナル操作)
- GPT-5.6 Sol: 88.8%
- Fable5: 83.1%
約5.7ポイントの差。エージェント的なタスク実行という一点に絞れば、Solのリードは明確だ。
私はこの数字をこう読む。Solは「手順を組んで実行する」タスクに強く、Fable5は総合力で肉薄しながらもエージェント実行の局面でわずかに後れを取る。逆に言えば、それ以外の領域——特にコーディングそのもの——ではFable5の実力が光る。総合スコアの僅差は、両者の強みが違う方向を向いていることの裏返しなのだ。
コーディングはFable5、エージェントタスクはGPT-5.6という使い分け
実務での評判を集めると、傾向はさらにはっきりする。純粋なコード生成・リファクタリング・バグ修正といった「書く」作業ではFable5が安定して選ばれている。一方、複数ステップにまたがるタスクの自律実行や、ツール呼び出しを繰り返すエージェント的な運用ではSolが優位という声が多い。断言しよう。「コードを書かせるならFable5、タスクを任せるならSol」——これが今の実務感覚に最も近い使い分けだ。
もちろんこれは白黒はっきり分かれる話ではない。Fable5でもエージェント運用は十分にできるし、Solでもコーディングは強い。ただしTerminal-Bench 2.1の5.7ポイント差は、無視できるほど小さくはない。迷ったときの判断軸として持っておく価値はある。
価格帯で見る現実的な選択
性能が僅差なら、次に効いてくるのは価格だ。GPT-5.6は3階層のラインナップで、100万トークンあたりSolが$5(入力)/$30(出力)、Terraが$2.50/$15、Lunaが$1/$6。対するFable5は、Max・Team Premiumなら週次利用枠の50%まで追加課金なしで使え、Pro・Team Standardではusage credits経由で$10(入力)/$50(出力)という水準になる。
ここで一つ強調したい。プラン内で使い放題に近いFable5と、常に従量課金のGPT-5.6を単純な$/Mtokだけで比べるのはフェアではない。すでにMax・Team Premiumを契約しているならFable5のコストは実質ゼロに近い。逆にAPI従量課金だけで比較するなら、最も安価なLunaがコスト最適解になる場面も多いだろう。「プランに含まれているか」という一点が、価格比較の結論を左右する。
結局どちらを選ぶべきか——ユースケース別の判断軸
私の結論はこうだ。日々のコーディング作業が中心で、すでにClaudeのプランを契約しているなら、Fable5を選ばない理由がない。追加コストなしで実務水準の実力が手に入る。一方、複数ステップの自律タスクやツール呼び出しを繰り返すエージェント的な運用が中心なら、Terminal-Bench 2.1で明確な差が出ているSolを検討する価値がある。コストを最優先するなら、Lunaという選択肢もある。
タスクの性質でモデルを使い分ける。当たり前のようで、実際にやっている開発者はまだ少ない。この記事がその第一歩になれば嬉しい。
まとめ
総合スコアはFable5とSolでほぼ互角。だが中身を分解すると、コーディングはFable5、エージェントタスクはSolという傾向がはっきり見える。「最強のAI」という問いに一つの答えはない——あるのは、自分のタスクに合った答えだけだ。