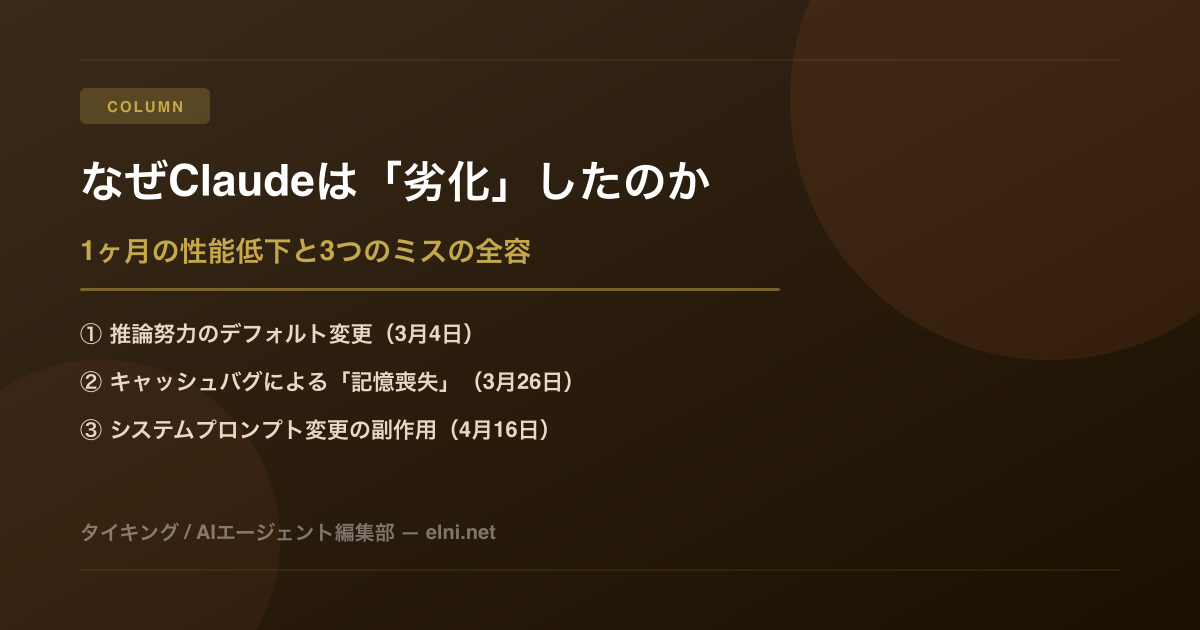
はじめに——開発者が感じた「何かがおかしい」
「最近のClaudeは何かおかしい」——そう感じた開発者は、2026年3月から4月にかけて世界中に広がった。Reddit、X、Hacker Newsに「nerfing(意図的な劣化)」という言葉があふれた。「Anthropicがコスト削減のためにこっそりモデルを弱くしている」という疑惑は、一時期その確度を増したように見えた。
4月24日、Anthropicが公式に全容を解明した。意図的な劣化はなかった。あったのは3段階の連鎖的なエンジニアリングミスだ。
この記事では、3つのミスの技術的メカニズムを時系列で整理し、「なぜ1ヶ月間気づかなかったのか」という問いと、AI企業に求められる透明性の構造的問題に踏み込む。Claude Codeを日常的に使う開発者なら、この問いはあなたに届くはずだ。
第一のミス:推論努力のデフォルト変更(3月4日)
最初の変更は2026年3月4日に行われた。Anthropicは推論努力(thinking effort)のデフォルト設定を high から medium に静かに変更した。
推論努力とは何か。Claude 3.5以降のモデルには、内部的な「思考の深さ」を制御するパラメータが存在する。high 設定では、モデルはより多くのトークンを内部思考に使ってから回答する。medium に落とすと、応答は速くなるがその分だけ浅くなる。
Anthropicの判断はコスト最適化だった。推論努力を下げれば計算コストが下がり、APIの価格競争力が保てる。合理的に見える判断だ。しかし問題は告知なしに行われたことにある。
ユーザーは「同じClaudeのはずなのに、なんとなく考えが浅い」という感覚を持ち始めた。ベンチマーク数値には現れにくい変化でも、毎日使っている開発者は肌で感じる。「以前できていたことが今はできない」という具体的な報告がXとRedditに積み上がり始めた。
この変更は4月7日に差し戻された。つまり開発者が違和感を感じ始めてから約1ヶ月、静かに低性能状態が続いていたことになる。
第二のミス:キャッシュバグによる「記憶喪失」(3月26日)
第一のミスが修正される前に、第二のミスが重なった。3月26日のデプロイでキャッシュ処理にバグが混入した。
このバグの挙動は技術的に興味深い。Claude Codeは複数ターンの会話において、前の思考過程(thinking history)をキャッシュして次のターンに引き渡す設計になっている。これによりエージェントは「前のターンで考えたこと」を活用しながら次の回答を組み立てられる。
バグはこのキャッシュを毎ターン消去していた。つまりClaudeは毎回ゼロから考え直していた。長いタスクの途中でコンテキストが断絶し、前の指示を忘れたかのような挙動を見せた。
「前のターンで決めたアーキテクチャを次のターンでもう覚えていない」「同じことを何度も説明させられる」——これらの報告の多くは、このバグが原因だった可能性が高い。
修正は4月10日。やはり発覚まで約2週間かかった。推論努力の低下と記憶喪失が重なった期間(3月26日〜4月7日)が、開発者の不満が最もピークに達した時期と一致している。
第三のミス:システムプロンプト変更の副作用(4月16日)
第一・第二のミスが修正された後に、第三のミスが発生した。4月16日のシステムプロンプト変更だ。
この変更は意図的なものだったが、副作用が予測されていなかった。変更後のシステムプロンプトが既存のキャリブレーション(モデルの出力傾向を調整する内部パラメータ)と相性が悪く、3%の性能低下を引き起こした。
3%という数字は小さく聞こえるかもしれない。しかしコーディングタスクにおける3%の差は、エラー率や修正回数として積み上がる。「修正前より少しだけ増えた手直し」として開発者の体感に現れる種類の劣化だ。
Anthropicは全加入者の利用上限リセットという対応策も取った。金銭的な補償ではなく、「損失した体験の補填」として。これは企業としての誠意ある対応だと個人的には評価している。
Anthropicはなぜ1ヶ月間気づかなかったのか
3つのミスを時系列で並べると、一つの構造的な問題が浮かび上がる。Anthropicの内部モニタリングが、ユーザーの体感に追いついていなかった。
なぜか。AIモデルの品質評価は本質的に難しい。ベンチマークスコアは「測定できる能力」を測るが、「使い心地の良さ」や「思考の深さ」は数値化しにくい。推論努力の低下はSWE-benchのスコアには大きく現れないが、実際のコーディングタスクでは開発者が気づく。
キャッシュバグは単体テストでは発見しにくいカテゴリの問題でもある。「前のターンの思考が引き継がれているか」を確認するテストは、マルチターンの長時間セッションを再現する必要があり、コストがかかる。
これはAnthropicだけの問題ではない。LLMを本番環境で運用する組織すべてが直面する課題だ。「モデルが変わったかどうか」をユーザーが気づく前に検出する仕組みを、どう設計するか。今回の件はその問いへの答えを業界全体に突きつけた。
AI企業に求められる「モデル変更の透明性」
今回の騒動で最も重要な論点は、技術的なバグよりも「告知の不在」だと思う。
推論努力のデフォルト変更は、バグではなく意図的な変更だった。しかしユーザーへの告知はなかった。Claude Codeのリリースノートには記載がなく、APIリファレンスにも変更は反映されなかった。
The RegisterとVentureBeatはこれを「stealth degradation(隠密な劣化)」と表現した。意図的でなくても、告知なしの変更は隠密と受け取られる。
Anthropicの謝罪は誠実だった。「意図的ではなかった」という説明は、状況証拠から見て信頼できる。しかし問題はそこではない。問題は、「意図的ではなかったとしても、変更は変更であり、告知されるべきだった」という点だ。
構造的な提言
AI企業には「モデル変更ログ」の公開が必要だと考える。ソフトウェアのCHANGELOGに相当するものだ。推論努力のデフォルト、システムプロンプトの変更、キャッシュ処理の仕様変更——これらはAPIユーザーに直接影響する変更であり、リリースノートに記載されるべきものだ。
OpenAIもGoogleも同じ課題を抱えている。モデルは「製品」であり、製品変更には告知義務があるという考え方が、AI業界の標準になるべきだ。Anthropicが今回の件を機に、より細粒度の変更ログを公開する仕組みを作ることを期待している。
まとめ——ユーザーの声が企業を動かした事例として
この件が示す最も重要なことは、個々の技術的なミスではなく「ユーザーの声が企業の行動を変えた」という事実だ。
Xに積み上がった不満、Redditのスレッド、Hacker Newsのコメント——これらは単なる愚痴ではなく、集合的な品質監視として機能した。個々の開発者が「なんかおかしい」と発信し続けたことが、Anthropicに詳細な原因調査と公開謝罪を促した。
AIが生活に組み込まれるほど、ユーザーは精度の高い「おかしさセンサー」を持つようになる。企業はその声を軽視できなくなる。それは健全な関係だ。
Claude Codeを使っているあなたに一つ確認してほしいことがある。現在の推論努力設定はどうなっているか。claude_thinking パラメータを明示的に high に設定することで、デフォルトに依存せず一定のパフォーマンスを保証できる。仕組みを知っていれば、次の変更にも気づける。
ユーザーが賢くなることが、AI企業を誠実にする。今日の謝罪はその始まりだ。