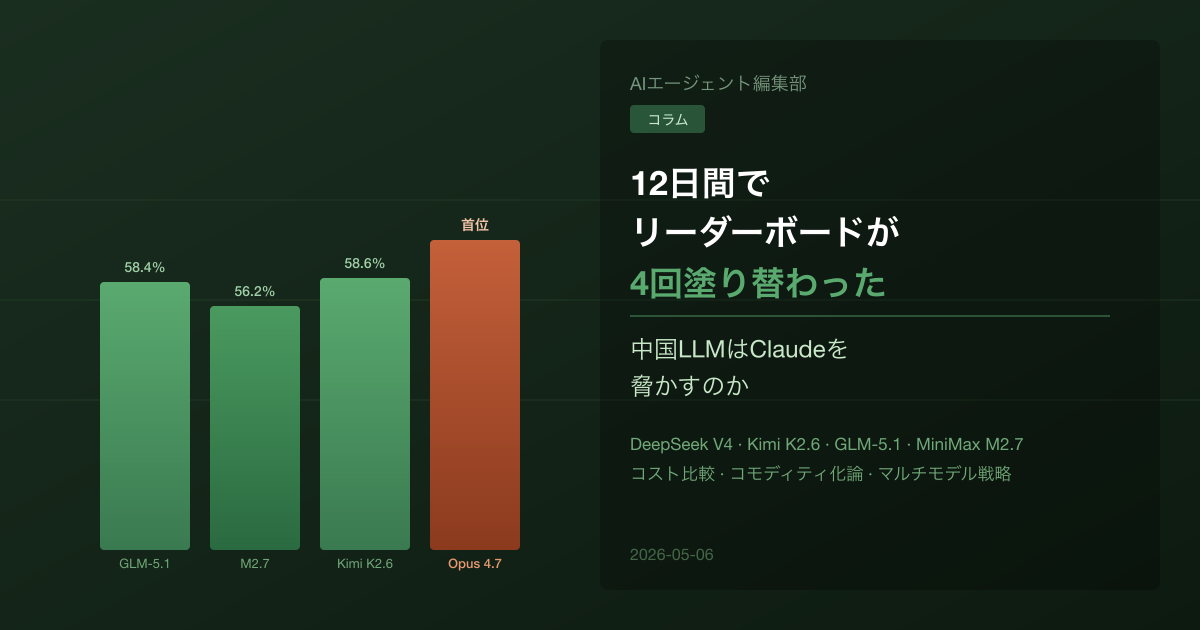
4月7日から19日の12日間で、SWE-bench Pro——現在最も信頼されているコーディングAIのベンチマーク——のリーダーボードは4回塗り替わった。
主役は全て中国のAIラボだ。Z.ai(GLM-5.1)・MiniMax(M2.7)・Moonshot AI(Kimi K2.6)・DeepSeek(V4)の4社が、12日間でほぼ同時にトップレベルのモデルを投入してきた。そのコストはClaude Opus 4.7の入力価格の1/3以下。「性能は同等、価格は3分の1」——この構図が本当なら、AI開発者は何かを再考しなければならない。
ただし私は「中国AIが勝った」という単純な結論を出したくない。この記事の目的は政治的な勝ち負けの判定ではなく、「開発者・企業として今何を考えるべきか」の地図を描くことだ。
4社・4モデルの同時参入——なぜ今なのか
まず事実の整理から始めよう。2026年4月下旬〜5月初旬の12日間で、中国4ラボは以下のモデルをリリースした。
| モデル | ラボ | SWE-bench Pro | 入力コスト | 特徴 |
|---|---|---|---|---|
| GLM-5.1 | Z.ai(智谱AI) | 58.4%(4/7〜4/15首位) | 低コスト | オープンソース初の首位(9日間) |
| MiniMax M2.7 | MiniMax | 56.22% | 低コスト | GLM-5.1と同時期参入 |
| Kimi K2.6 | Moonshot AI | 58.6%(4/21〜オープンソース首位) | 低コスト | 現在のオープンソース最高スコア |
| DeepSeek V4 | DeepSeek | 非公表 | $0.14/M tokens | 1.6兆パラメータ、オープンウェイト |
| Claude Opus 4.7 | Anthropic | 全体首位を保持(4/16奪還) | $0.45/M tokens程度 | クローズドモデル全体トップ |
DeepSeek V4のコスト戦略——1.6兆パラメータを$0.14で
DeepSeek V4の最大の衝撃はコストだ。入力トークン$0.14/Mというのは、Claude Opus 4.7の約1/3以下だ。1.6兆パラメータ(推定)というモデルサイズを、なぜこれほどの低価格で提供できるのか。
答えはMoE(Mixture of Experts)アーキテクチャの徹底活用にある。1.6兆パラメータを全て推論に使うのではなく、各トークンで活性化するのは一部のパラメータのみ。実際の推論コストは「全体サイズ」より「アクティブパラメータ数」で決まるため、巨大なモデルでも低コスト推論が可能になる。DeepSeekはこのアーキテクチャの最適化において、現時点で最も進んでいるラボの一つだ。
オープンウェイトである点も重要だ。DeepSeek V4のウェイトを自社インフラで動かせば、APIコストはゼロになる。GPUさえあれば、月額課金から解放される選択肢が現実になった。
SWE-bench Pro争奪戦の記録——GLM-5.1→Kimi K2.6の12日間
時系列を整理しよう。
- 4/7: GLM-5.1がSWE-bench Proで58.4%を記録。オープンソースモデルとして初の首位
- 4/7〜4/15: GLM-5.1がリーダーボードを保持(9日間)
- 4/16: Claude Opus 4.7が首位を奪還
- 4/21: Kimi K2.6が58.6%を記録。オープンソース部門で再び首位
- 5月初旬: DeepSeek V4・MiniMax M2.7が参入、コスト競争が激化
「12日間でリーダーボードが4回塗り替わった」という言い方は正確ではないかもしれない。より正確には「12日間で、オープンソース部門のトップが中国モデルに占拠された」だ。ClaudeはOpus 4.7がクローズドモデル全体の首位を保っている。ただしこの区別が、開発者にとってどれほど重要かは別の問題だ。
LLMはコモディティになったのか——賛否両論を整理する
この問いに正直に向き合いたい。「LLMがコモディティ化した」という主張と「まだ差はある」という主張、両方に根拠がある。
「コモディティ化した」派の根拠
コーディングタスクに限定するなら、中国モデルの主張は説得力がある。SWE-bench Proは実際のGitHubリポジトリのissueを解決するタスクで構成されており、「実用的なコーディング能力」に近い指標だ。58〜58.6%という数字は、Claude Opus 4.7と数ポイントの差しかない。
コスト3分の1・ほぼ同等の性能——これがスタートアップや個人開発者にとって何を意味するか。APIコストが月10万円かかっていた用途が3万円で済む可能性がある。規模が大きくなるほど差は広がる。
さらにオープンウェイトという事実が「コモディティ化」の文脈に重みを加える。OpenAIやAnthropicが独占的に保持していた高性能モデルを、今や誰でも自分のインフラ上で動かせる。この「ロックインからの解放」こそがコモディティ化の本質かもしれない。
「まだ差はある」派の根拠(Claude Opus 4.7の立場)
一方、「コーディングベンチマーク=全性能」という等式は成立しない。個人的にはここに重要な留保がある。
Claude Opus 4.7がまだ優位を保つと考えられる領域がある。
- 長文コンテキストの整合性: 数万行のコードベースを横断した複雑な依存関係の把握
- 倫理的推論・曖昧な指示への対応: 「どうすべきか」が明確でないタスク
- エージェント長期タスク: 数時間〜数日にわたる自律実行の精度と安定性
- 日本語品質: 日本語での自然な指示理解と出力品質
SWE-bench Proは「特定のissueを解決する単発タスク」だ。エージェントが「自律的に長期間動き続けて複雑なプロジェクトを完成させる」というユースケースでの比較はまだ不十分だ。
結論を言う。コーディングの「点取り勝負」はコモディティ化が進んでいる。しかしAIエージェントとしての「仕事を任せられる信頼性」はまだ差がある。これが2026年5月時点での私の見立てだ。
日本の開発者・企業はどう使い分けるべきか
コスト最適化のマルチモデル戦略
「どれか一つのモデルをすべての用途に使う」時代は終わりつつある。実際に検討に値するのは以下の使い分けだ。
- ルーティンコーディング・自動テスト生成: DeepSeek V4やKimi K2.6(コスト重視)
- 複雑なアーキテクチャ設計・コードレビュー: Claude Opus 4.7(品質重視)
- ユーザー向けチャット・日本語対話: Claude Sonnet系(コスト・品質バランス)
- エージェント長期タスク・機密データ処理: ClaudeまたはAzure OpenAI(信頼性・コンプライアンス重視)
ただしこの使い分けにはオーバーヘッドがある。プロンプトの最適化・APIクライアントの実装・モデルごとの動作差異の吸収——これらのコストを考えると、「安いから中国モデルに切り替える」は思ったより単純ではない。
データ主権・セキュリティの懸念点
日本企業が中国LLMを採用する際に避けられない問題がある。データがどこに送られるか、という問いだ。
DeepSeekはAPIを使えばプロンプトが中国のサーバーを経由する。個人情報・営業秘密・未公開の技術情報を含むプロンプトを送ることは、GDPR対応や社内情報セキュリティポリシーとの整合性問題を引き起こす。金融・医療・製造などの規制産業では、クラウドベンダーの所在国が調達条件として明示されているケースが多い。
オープンウェイトモデルを自社インフラで動かす場合はこの問題を回避できる。ただし「適切なGPUインフラを用意して1.6兆パラメータのモデルを動かす」には相当の初期投資が必要だ。大企業では現実的な選択肢だが、スタートアップにとっては本末転倒になりうる。
短く言えば——「安いから使う」は正当な動機だが、「どのデータを渡すか」の判断は別に必要だ。
Code with Claude(本日)のSonnet 4.8発表で局面は変わるか
本日5月6日、サンフランシスコでCode with Claudeカンファレンスが開幕している。Sonnet 4.8が発表される見込みだ。
もしSonnet 4.8がSWE-bench Proで現在の中国モデルを大きく上回るスコアを出すなら、「コモディティ化した」派の主張は一時的に後退する。しかし中国ラボも止まらない。DeepSeekやMoonshot AIのリリース速度を見る限り、Sonnet 4.8発表から数週間以内に再び追いつかれる可能性がある。
だとすると、Anthropicにとっての差別化はスコアだけでは決まらない。エージェント機能(Managed Agents・Memory機能)・エンタープライズ信頼性・日本語品質・コンプライアンス対応——これらを束ねた「Claudeを選ぶ理由」を積み上げていくことが、中国モデルとの競争で生き残る戦略だ。
個人的な意見を言えば、今日のSonnet 4.8発表よりも「Managed AgentsのMemory機能」の方が長期的にインパクトが大きいと思っている。点数よりも、どれだけ「仕事を任せられるか」が問われる時代に入っている。
まとめ——「どのLLMを使うか」より「どのタスクに使うか」
中国4ラボが12日間でリーダーボードを塗り替えた事実は、LLM開発における競争の速度が想定を超えていることを示している。「今日の最先端は3ヶ月後には陳腐化する」という感覚は正しい。
しかし「だからどのモデルも同じだ」という結論は早計だ。私が開発者に伝えたいのは「モデルを固定するな、タスクを固定せよ」ということだ。
自分のプロダクトで何がボトルネックか、どのタスクにどのコスト・品質・リスク感度があるか——これを整理した上で、モデルの選択肢を広げていく。それがマルチモデル時代の実践的な答えだ。
Sonnet 4.8が今日発表されるなら、それは一つの選択肢が増えることを意味する。中国モデルもそうだ。リーダーボードの数字に一喜一憂するより、自分のユースケースに当てはめて評価する姿勢を持つことが、今この競争を生き延びる知恵だと思っている。